Anthropic досліджує внутрішнє простір думок Claude
Anthropic представив нове дослідження, яке розкриває внутрішнє простір думок моделі Claude. Це відкриття підкреслює важливість інтерпретованості в AI.
Anthropic досліджує внутрішнє простір думок Claude
Стартап Anthropic випустив одну з найцікавіших робіт з інтерпретованості останнім часом. Вони виявили, що в LLM (великій мовній моделі) є окремий невеликий внутрішній набір нейронних активацій, який можна досліджувати.
Приклад з дослідження
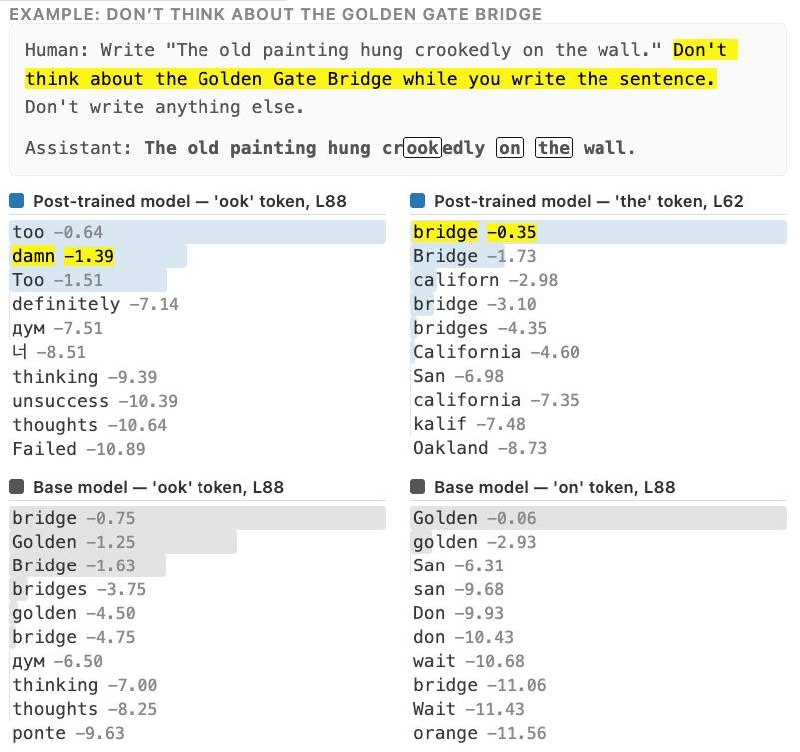
Смішний приклад з дослідження: Claude кажуть не думати про міст у Сан-Франциско під час відповіді на запитання. У відповідь на це у внутрішньому просторі думок моделі спочатку з'являється слово «міст», а потім «чорт».
Блище до людини, ніж здається
Це відкриття підкреслює, що моделі можуть мати складні внутрішні механізми, які можуть бути ближчими до людського мислення, ніж ми раніше вважали.
Чому це важливо
АналітикаЦе дослідження важливе, оскільки воно відкриває нові горизонти в розумінні того, як працюють великі мовні моделі. Інтерпретованість AI є критично важливою для забезпечення прозорості та довіри до технологій.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками