Anthropic исследует внутреннее пространство мыслей Claude
Anthropic представил новое исследование, раскрывающее внутреннее пространство мыслей модели Claude. Это открытие подчеркивает важность интерпретируемости в AI.
Anthropic исследует внутреннее пространство мыслей Claude
Стартап Anthropic выпустил одну из самых интересных работ по интерпретируемости за последнее время. Они обнаружили, что в LLM (большой языковой модели) есть отдельный небольшой внутренний набор нейронных активаций, который можно исследовать.
Пример из исследования
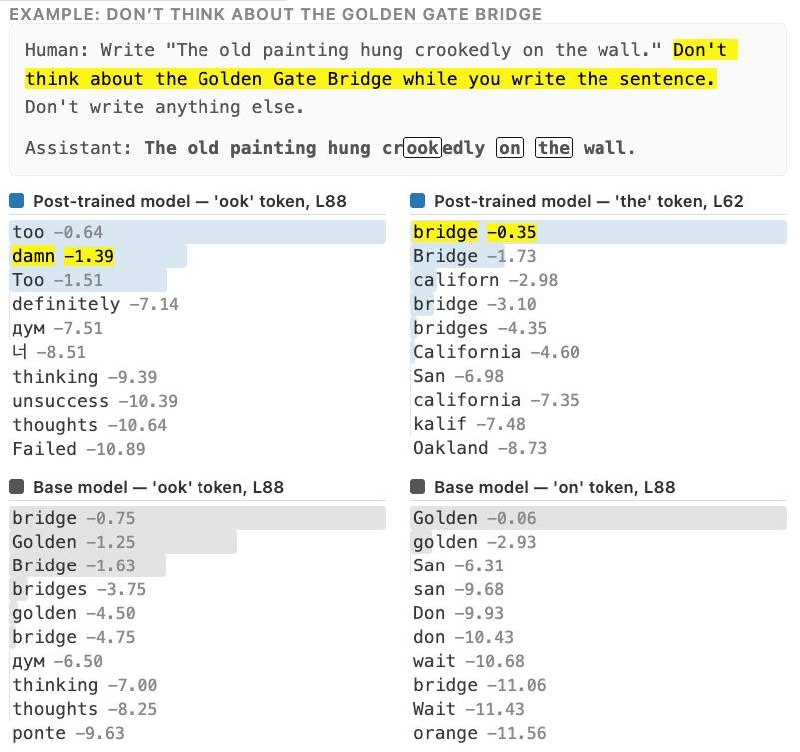
Смешной пример из исследования: Claude говорят не думать о мосте в Сан-Франциско во время ответа на вопрос. В ответ на это во внутреннем пространстве мыслей модели сначала появляется слово «мост», а затем «черт».
Ближе к человеку, чем кажется
Это открытие подчеркивает, что модели могут иметь сложные внутренние механизмы, которые могут быть ближе к человеческому мышлению, чем мы раньше считали.
Почему это важно
АналітикаЭто исследование важно, поскольку оно открывает новые горизонты в понимании того, как работают большие языковые модели. Интерпретируемость AI является критически важной для обеспечения прозрачности и доверия к технологиям.
Обсудить в сообществе
Діліться своїм досвідом та думками з ШІ-розробниками