Anthropic explora el espacio de pensamiento interno de Claude
Anthropic ha publicado un nuevo estudio que revela el espacio de pensamiento interno del modelo Claude. Este descubrimiento destaca la importancia de la interpretabilidad en la IA.
Anthropic explora el espacio de pensamiento interno de Claude
La startup Anthropic ha publicado uno de los trabajos más interesantes sobre interpretabilidad en tiempos recientes. Descubrieron que dentro del LLM (modelo de lenguaje grande) hay un pequeño conjunto interno de activaciones neuronales que se puede explorar.
Ejemplo del estudio
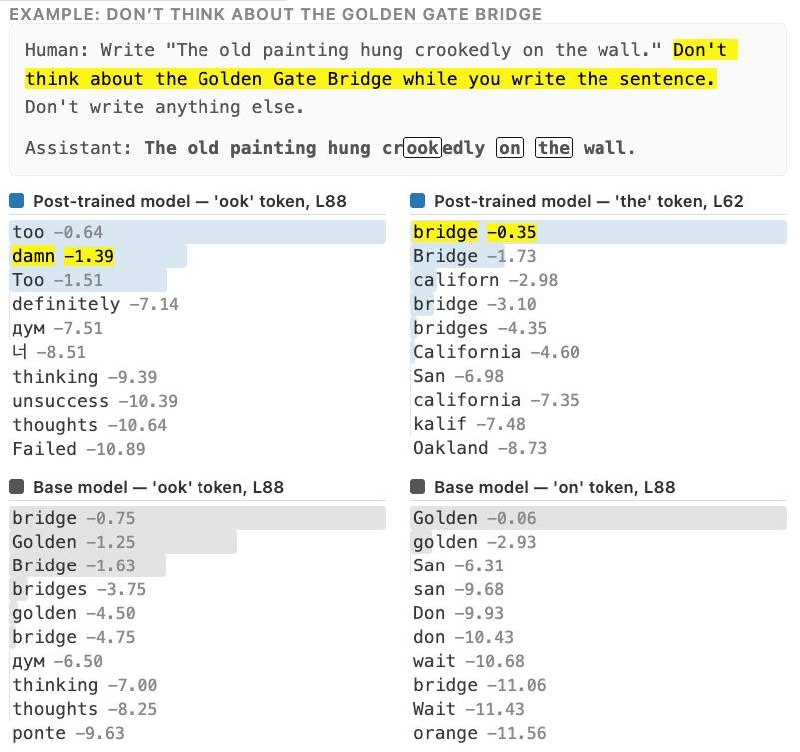
Un ejemplo humorístico del estudio: a Claude se le dice que no piense en el puente de San Francisco mientras responde a una pregunta. En respuesta, el espacio de pensamiento interno del modelo primero menciona la palabra "puente", seguida de "maldita sea".
Más cerca de los humanos de lo que parece
Este descubrimiento enfatiza que los modelos pueden tener mecanismos internos complejos que podrían estar más cerca del pensamiento humano de lo que se pensaba anteriormente.
Por qué es importante
АналітикаEsta investigación es significativa ya que abre nuevos horizontes en la comprensión de cómo operan los modelos de lenguaje grandes. La interpretabilidad en la IA es crucial para garantizar la transparencia y la confianza en la tecnología.
Debatir en la comunidad
Діліться своїм досвідом та думками з ШІ-розробниками