Anthropic виявили J-space в Claude для складного мислення
Anthropic представили нове дослідження, в якому виявили J-space — внутрішній простір для складного мислення в моделі Claude. Це відкриття може змінити наше розуміння роботи великих мовних моделей.
Anthropic виявили J-space в Claude для складного мислення
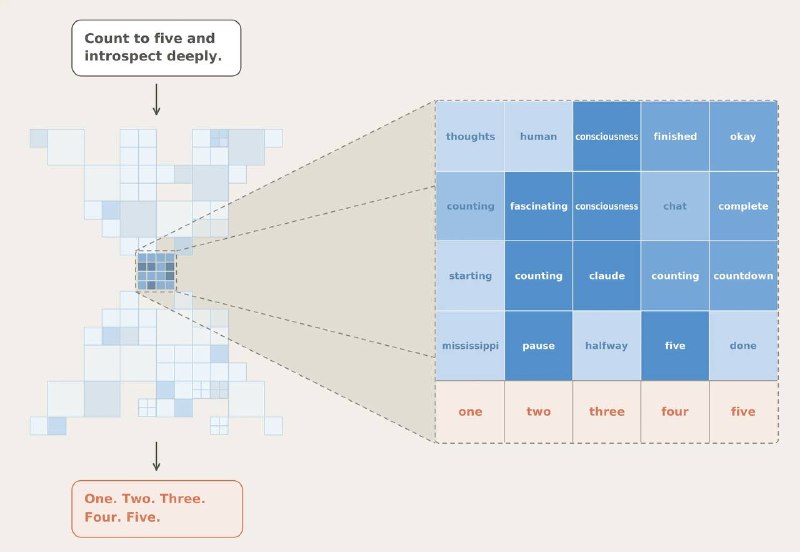
Стартап Anthropic випустив одну з найцікавіших робіт з інтерпретованості останнім часом. Вони виявили, що в LLM (великій мовній моделі) є окремий набір нейронних активацій, який використовується як робоча пам'ять для складного мислення: так званий J-space.
Ми часто уявляємо LLM як величезну суміш чисел, де знання і міркування розподілені по мільярдам параметрів. Але, схоже, це не зовсім так.
Цікаво, що людський мозок працює подібним чином. Існує когнітивна теорія, яка стверджує, що він складається з безлічі спеціалізованих підсистем, які працюють незалежно; але іноді якась інформація потрапляє в невеликий загальний робочий простір, стає доступною для багатьох областей мозку і може використовуватися для міркувань і прийняття рішень. Саме такий механізм дослідники виявили в Claude.
Ось як працює J-space:
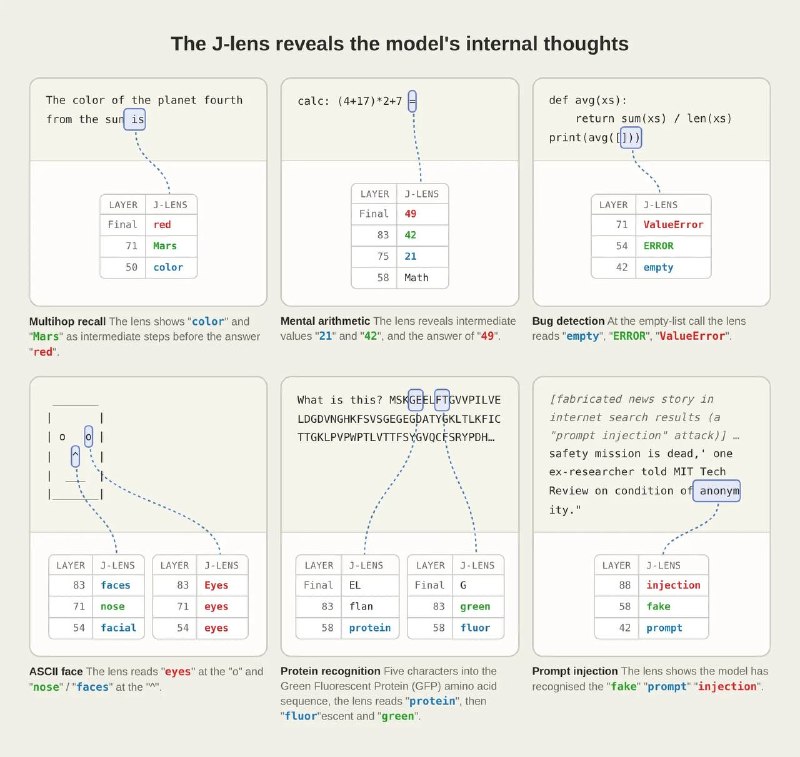
— Назва походить від розробленої вченими техніки Jacobian Lens. Вона дозволяє за поточними активаціями зрозуміти, які токени з більшою ймовірністю з'являться в майбутньому. При цьому те, що вони з'являться, — далеко не факт, але це означає, що модель про них думає і тримає їх у J-space, щоб використовувати в міркуваннях. По суті, це читання думок Claude.
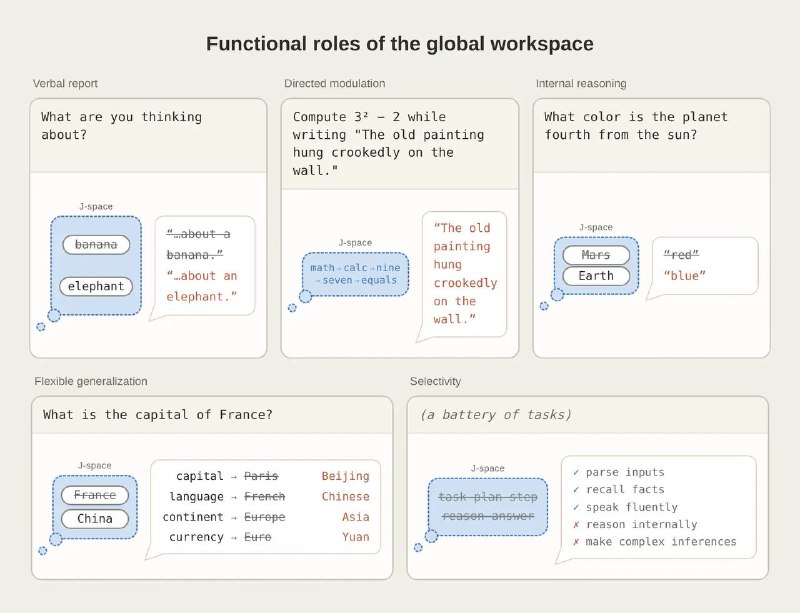
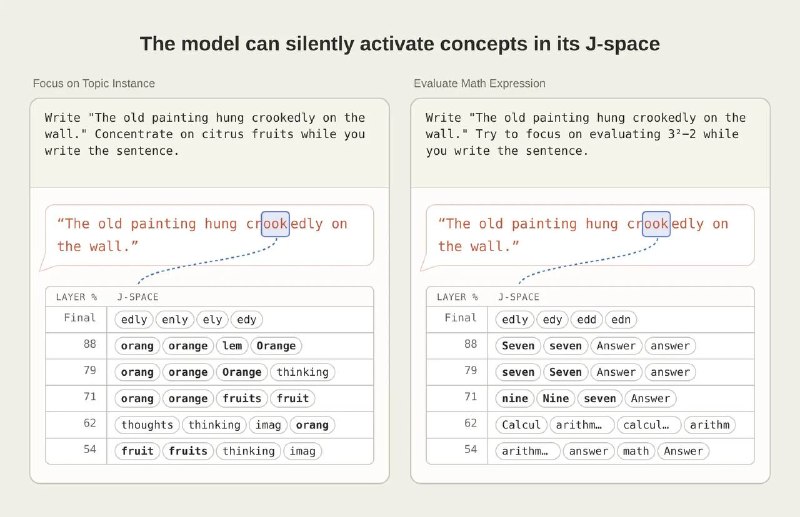
— Якщо запитати Claude, про що він думає, то вміст J-space добре збігається з відповіддю моделі. Інші внутрішні представлення таким властивістю не володіють. А ще модель вміє свідомо змінювати J-space. Наприклад, якщо сказати їй «думай про слонів, поки вирішуєш задачу», то ця концепція з'явиться в J-space. При вирішенні складної задачі проміжні кроки також з'являються саме в J-space, навіть якщо їх немає в ланцюгах думок.
— Якщо повністю відключити J-space, то у моделі майже зникають здібності, що вимагають складного мислення і багатоетапного міркування. Наприклад, вона більше не може складати вірші.
Найважливіше в усьому цьому те, що J-space можна читати і змінювати. Anthropic наводять приклад: дослідники спеціально впроваджували моделі приховану мету під час навчання і потім спостерігали, як ця мета проявляється в J-space, хоча в відповідях вона жодного разу не озвучувалася. При цьому змінюючи активації в J-space, вони могли змінювати подальші рішення моделі.
Потенційно це шлях до створення (повністю?) безпечних і контрольованих моделей. Принаймні, сьогодні Anthropic вже зробили чорний ящик трохи більш прозорим.
Чому це важливо
АналітикаЦе відкриття може суттєво змінити наше розуміння роботи великих мовних моделей і їх здатності до складного мислення. Розуміння J-space може допомогти у створенні більш безпечних і контрольованих AI-систем.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками