Anthropic descubre J-space en Claude para el pensamiento complejo
Anthropic ha publicado un estudio innovador que revela J-space, un espacio interno para el pensamiento complejo en el modelo Claude. Este descubrimiento podría cambiar nuestra comprensión de cómo funcionan los modelos de lenguaje grandes.
Anthropic descubre J-space en Claude para el pensamiento complejo
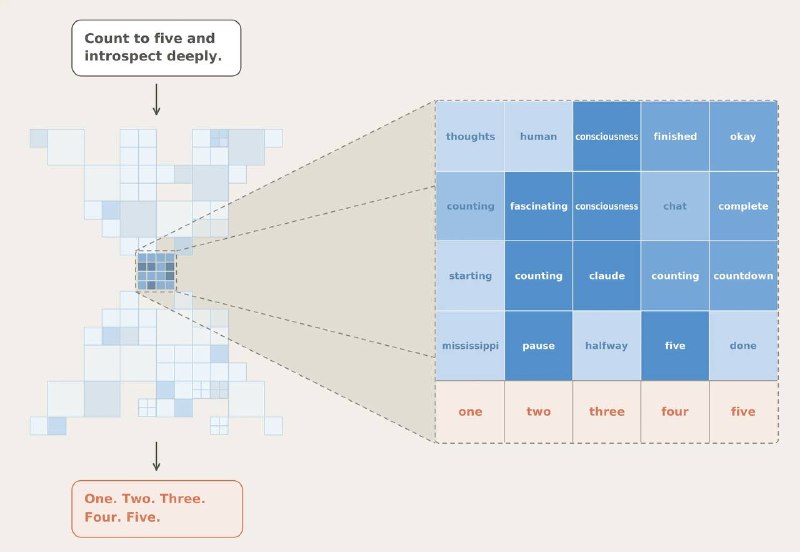
La startup Anthropic ha publicado uno de los trabajos más interesantes sobre interpretabilidad en tiempos recientes. Descubrieron que en los LLM (modelos de lenguaje grandes) hay un conjunto separado de activaciones neuronales que se utiliza como memoria de trabajo para el pensamiento complejo: el llamado J-space.
A menudo imaginamos los LLM como un enorme revoltijo de números, donde el conocimiento y el razonamiento están distribuidos a través de miles de millones de parámetros. Sin embargo, parece que no es del todo así.
Curiosamente, el cerebro humano funciona de manera similar. Existe una teoría cognitiva que sostiene que está compuesto por muchos subsistemas especializados que operan de forma independiente; pero a veces, cierta información entra en un pequeño espacio de trabajo compartido, volviéndose accesible para muchas áreas del cerebro y puede ser utilizada para razonamiento y toma de decisiones. Este es precisamente el mecanismo que los investigadores encontraron en Claude.
Así es como funciona J-space:
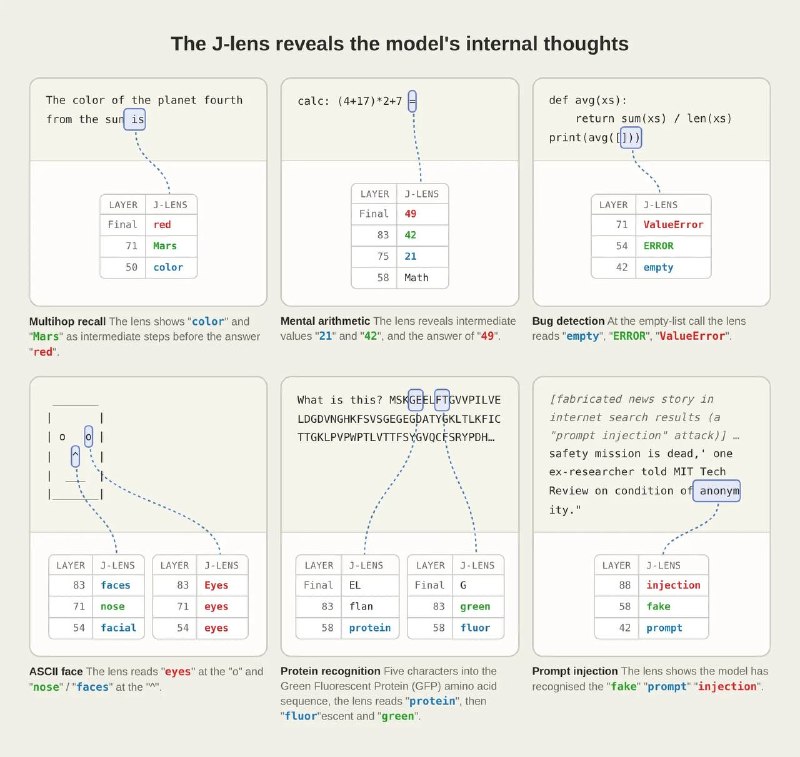
— El nombre proviene de una técnica desarrollada por los científicos llamada Jacobian Lens. Esta técnica permite entender, a partir de las activaciones actuales, qué tokens tienen más probabilidades de aparecer en el futuro. Si bien su aparición no está garantizada, indica que el modelo está pensando en ellos y los mantiene en J-space para su uso en razonamientos. En esencia, esto es leer los pensamientos de Claude.
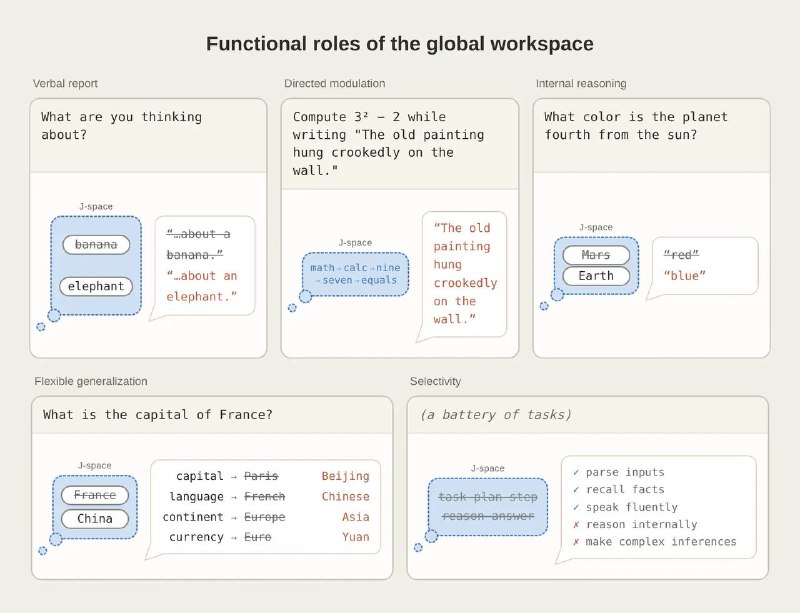
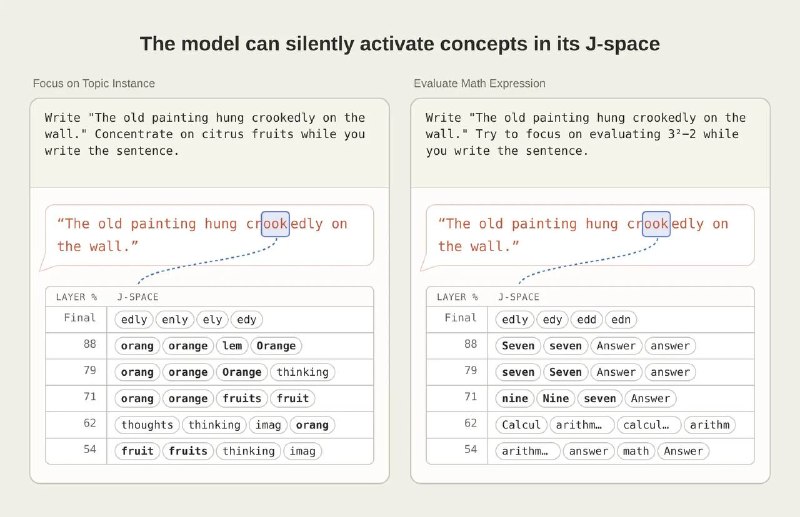
— Si le preguntas a Claude en qué está pensando, el contenido de J-space coincide bien con la respuesta del modelo. Otras representaciones internas no poseen esta propiedad. Además, el modelo puede cambiar J-space de manera consciente. Por ejemplo, si le dices "piensa en elefantes mientras resuelves un problema", ese concepto aparecerá en J-space. Al resolver un problema complejo, los pasos intermedios también aparecen dentro de J-space, incluso si no están presentes en las cadenas de pensamiento.
— Si J-space se desactiva por completo, el modelo casi pierde sus habilidades que requieren pensamiento complejo y razonamiento en múltiples pasos. Por ejemplo, ya no puede componer poesía.
Lo más importante de todo esto es que J-space se puede leer y modificar. Anthropic proporciona un ejemplo: los investigadores implantaron deliberadamente un objetivo oculto en el modelo durante el entrenamiento y luego observaron cómo este objetivo se manifestaba en J-space, aunque nunca se mencionó directamente en las respuestas. Al modificar las activaciones en J-space, podían cambiar las decisiones posteriores del modelo.
Potencialmente, este es un camino para crear modelos (¿completamente?) seguros y controlables. Al menos, hoy Anthropic ha hecho que la caja negra sea un poco más transparente.
Por qué es importante
АналітикаEste descubrimiento podría alterar significativamente nuestra comprensión de cómo funcionan los modelos de lenguaje grandes y su capacidad para el pensamiento complejo. Comprender J-space puede ayudar en el desarrollo de sistemas de IA más seguros y controlables.
Debatir en la comunidad
Діліться своїм досвідом та думками з ШІ-розробниками