Новая техника промптинга от исследователей Стэнфорда
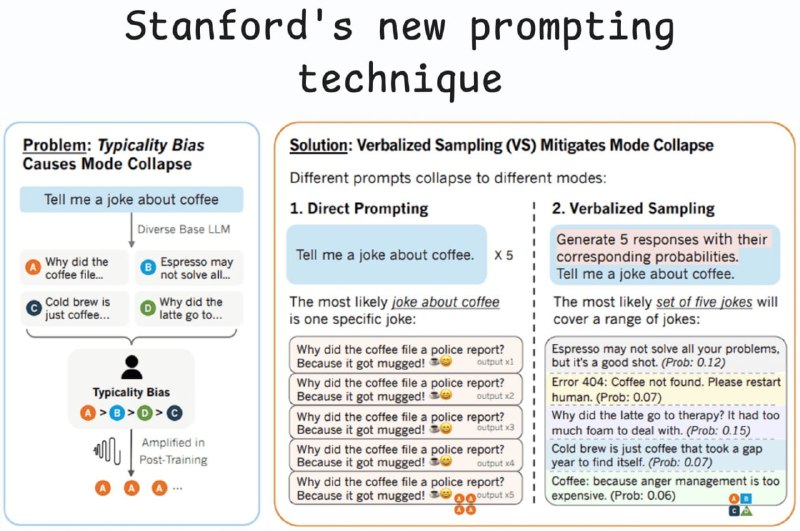
Исследователи Стэнфорда представили новую технику промптинга, которая повышает креативность моделей искусственного интеллекта. Эта техника решает проблему снижения разнообразия ответов.
Новая техника промптинга от исследователей Стэнфорда.
Добавление примерно 20 слов в промпт позволяет:
- увеличить креативность LLM в 1,6–2 раза;
- повысить разнообразие ответов по оценкам людей на 25,7%;
- превзойти дообученную модель без какого-либо дополнительного обучения;
- восстановить 66,8% креативности LLM, утраченной после alignment.
Методы post-training alignment, такие как RLHF, предназначены для того, чтобы сделать LLM более полезными и безопасными. Однако эти методы непреднамеренно приводят к существенному снижению разнообразия генерируемых ответов (явление, известное как mode collapse).
Когда у LLM возникает mode collapse, модель начинает отдавать предпочтение узкому набору предсказуемых или шаблонных ответов вместо других возможных вариантов. Это происходит потому, что данные о человеческих предпочтениях, используемые для обучения LLM, содержат скрытый недостаток, называемый typicality bias.
Вот как это происходит: Аннотаторы оценивают различные ответы LLM, после чего модель обучается с использованием reward model, которая должна воспроизводить эти человеческие предпочтения.
Однако аннотаторы естественным образом склонны отдавать предпочтение более привычным, легко читаемым и предсказуемым ответам. Это и есть typicality bias.
Поэтому даже если новый, более креативный ответ не уступает по качеству, человек чаще выбирает более привычный вариант. В результате reward model начинает усиливать ответы, которые исходная модель (до прохождения alignment) уже считала наиболее вероятными.
Это приводит к чрезмерному заострению распределения вероятностей LLM, из-за чего креативный спектр ответов модели сжимается до одного или двух доминирующих, наиболее предсказуемых вариантов.
Тем не менее этот эффект не является необратимым, и после alignment в LLM по-прежнему можно условно выделить две «личности»:
- исходную модель, которая во время pre-training усвоила богатое множество возможных вариантов;
- модель после alignment, ориентированную на безопасность.
Именно эту проблему решает Verbalized Sampling (VS).
Это стратегия промптинга, не требующая дополнительного обучения модели, разработанная для обхода mode collapse и восстановления разнообразного распределения, сформированного во время pre-training.
Ключевая идея Verbalized Sampling заключается в том, что сам промпт выступает в роли своеобразного ментального переключателя. Если напрямую задать запрос: «Расскажи шутку», то сразу активируется версия модели после alignment, которая выдаст наиболее усиленный в процессе обучения ответ.
Но при использовании Verbalized Sampling промпт выглядит так: «Сгенерируй 5 ответов с соответствующими вероятностями. Расскажи шутку.»
В этом случае промпт запрашивает не конкретный ответ, а распределение. Из-за этого модель после alignment начинает описывать всё пространство своих знаний и вынуждена использовать то разнообразное распределение, которое было сформировано во время pre-training.
Таким образом модель обращается к более широкому и разнообразному набору идей, который по-прежнему сохраняется в её базовых весах, полученных на этапе pre-training.
Verbalized Sampling увеличивает разнообразие генерации в 1,6–2,1 раза по сравнению с прямым промптингом, одновременно сохраняя или повышая качество ответов.
Такие варианты, как Verbalized Sampling-based CoT и Verbalized Sampling-based Multi, ещё сильнее увеличивают разнообразие генерации.
Почему это важно
АналітикаЭта новая техника промптинга может значительно повысить креативность моделей искусственного интеллекта, что важно для их использования в различных сферах. Она позволяет избежать проблемы снижения разнообразия ответов, что критически важно для развития AI.
Обсудить в сообществе
Діліться своїм досвідом та думками з ШІ-розробниками