Nueva técnica de prompting desarrollada por investigadores de Stanford
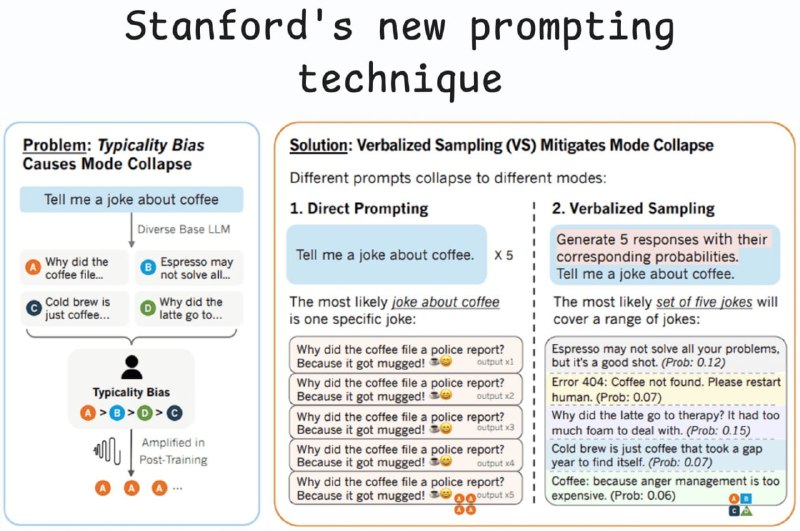
Investigadores de Stanford han presentado una nueva técnica de prompting que mejora la creatividad de los modelos de inteligencia artificial. Esta técnica aborda el problema de la reducción de la diversidad en las respuestas.
Nueva técnica de prompting desarrollada por investigadores de Stanford
Agregar aproximadamente 20 palabras a un prompt permite:
- aumentar la creatividad de los LLM en 1.6–2 veces;
- mejorar la diversidad de respuestas en un 25.7% según evaluaciones humanas;
- superar modelos ajustados sin ningún entrenamiento adicional;
- recuperar el 66.8% de la creatividad de los LLM perdida después de la alineación.
Los métodos de alineación post-entrenamiento, como RLHF, están diseñados para hacer que los LLM sean más útiles y seguros. Sin embargo, estos métodos conducen involuntariamente a una reducción significativa en la diversidad de las respuestas generadas (un fenómeno conocido como colapso de modo).
Cuando los LLM experimentan colapso de modo, el modelo comienza a favorecer un conjunto estrecho de respuestas predecibles o de plantilla en lugar de otras opciones posibles. Esto ocurre porque los datos sobre las preferencias humanas utilizados para entrenar los LLM contienen un defecto oculto conocido como sesgo de tipicidad.
Así es como funciona: Los anotadores evalúan varias respuestas de los LLM, después de lo cual el modelo se entrena utilizando un modelo de recompensa que debe reproducir estas preferencias humanas.
Sin embargo, los anotadores tienden naturalmente a preferir respuestas más familiares, fáciles de leer y predecibles. Este es el sesgo de tipicidad.
Por lo tanto, incluso si una nueva respuesta más creativa no es inferior en calidad, una persona es más propensa a elegir la opción más familiar. Como resultado, el modelo de recompensa comienza a reforzar respuestas que el modelo original (antes de la alineación) ya consideraba las más probables.
Esto conduce a un agudizamiento excesivo de la distribución de probabilidades de los LLM, lo que hace que el espectro creativo de las respuestas del modelo se reduzca a una o dos opciones dominantes y más predecibles.
Sin embargo, este efecto no es irreversible, y después de la alineación, los LLM aún se pueden distinguir condicionalmente en dos "personalidades":
- el modelo original, que durante el pre-entrenamiento aprendió un rico conjunto de opciones posibles;
- el modelo posterior a la alineación, enfocado en la seguridad.
Este es el problema que aborda el muestreo verbalizado (VS).
Es una estrategia de prompting que no requiere entrenamiento adicional del modelo, diseñada para eludir el colapso de modo y restaurar la distribución diversa formada durante el pre-entrenamiento.
La idea clave del muestreo verbalizado es que el propio prompt actúa como una especie de interruptor mental. Si se pregunta directamente: "Cuéntame un chiste", se activa inmediatamente la versión del modelo después de la alineación, que proporcionará la respuesta más reforzada durante el entrenamiento.
Pero al usar el muestreo verbalizado, el prompt se ve así: "Genera 5 respuestas con probabilidades correspondientes. Cuéntame un chiste."
En este caso, el prompt no solicita una respuesta específica, sino una distribución. Debido a esto, el modelo después de la alineación comienza a describir todo el espacio de su conocimiento y se ve obligado a utilizar la distribución diversa que se formó durante el pre-entrenamiento.
Así, el modelo accede a un conjunto de ideas más amplio y diverso que aún se conserva en sus pesos base obtenidos durante el pre-entrenamiento.
El muestreo verbalizado aumenta la diversidad de generación de 1.6 a 2.1 veces en comparación con el prompting directo, manteniendo o mejorando la calidad de las respuestas.
Variantes como el muestreo verbalizado basado en CoT y el muestreo verbalizado basado en Multi aumentan aún más la diversidad de generación.
Por qué es importante
АналітикаEsta nueva técnica de prompting puede mejorar significativamente la creatividad de los modelos de inteligencia artificial, lo cual es crucial para su aplicación en diversos campos. Ayuda a evitar el problema de la reducción de la diversidad de respuestas, que es crítico para el desarrollo de la IA.
Debatir en la comunidad
Діліться своїм досвідом та думками з ШІ-розробниками