Современная индустрия искусственного интеллекта долгое время развивалась по пути масштабирования генеративных моделей. Мы привыкли использовать большие языковые модели (LLM) уровня GPT-6.1 Sol, Claude Opus 5.5, Claude Fable или Gemini 3.8 Flash для любых задач: от написания эссе до парсинга статусов заказов. Однако когда речь заходит о построении надёжного программного обеспечения, генерация текста становится узким местом: модели тратят секунды на пошаговое развёртывание токенов, галлюцинируют невалидным JSON, требуют бесконечных регулярных выражений и стоят слишком дорого для микросервисной архитектуры.
Jev от лаборатории TypeSafe AI — первая в мире модель нового класса, известного как System One AI. Она вообще не генерирует текст. Jev создана исключительно для мгновенных, типизированных, структурных решений внутри программных систем: классификация, маршрутизация, оценка по рубрикам, проверка гипотез и файрволы для агентов с задержкой около 100 мс и стоимостью $0.042 за 1 миллион токенов.
В этом руководстве мы как практики разберём технологию Jev до мельчайших деталей: фундаментальное различие между System One и System Two, три ключевых примитива, математику калиброванной уверенности, архитектурные паттерны, готовые пайплайны на TypeScript и Python, а также изучим 10 прорывных реальных кейсов с реальными чеками стоимости и видеодемонстрациями.
Практический инструментарий от господина Юрия (@yuriisams):
Для практического использования Jev в Claude Code загрузите авторский архив с готовыми хуками UserPromptSubmit для автоматической маршрутизации моделей (jev-router) и динамического подбора скиллов (jev-skills):
Скачать полный архив JEV-Guide.zip (28 KB) →
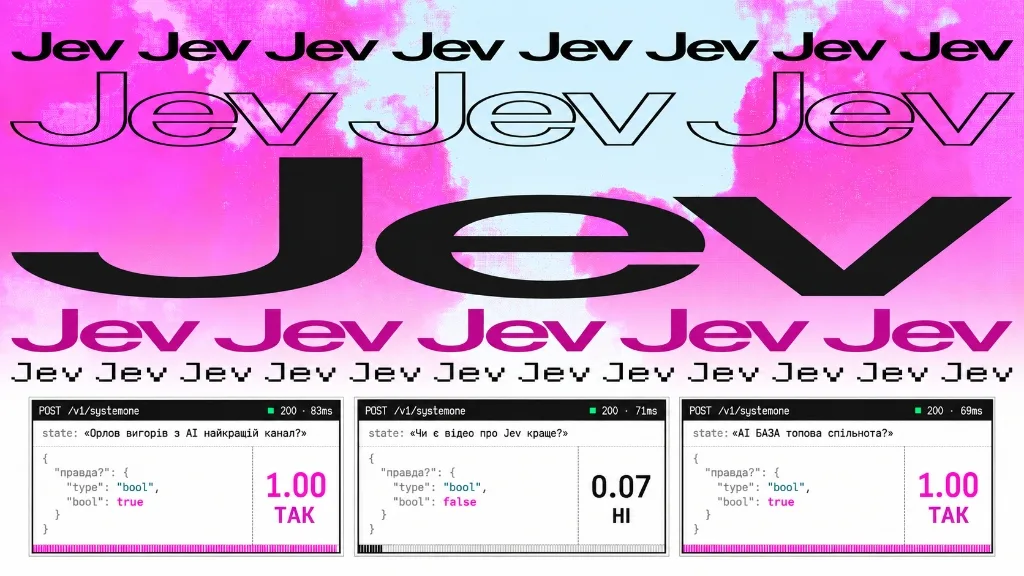 Демонстрация скорости TypeSafe Jev: мгновенная верификация утверждений с задержкой 69–83 мс и калиброванной уверенностью
1. Парадигмальный сдвиг: System One против классических LLM (System Two)
Название концепции происходит из когнитивной психологии и фундаментального труда лауреата Нобелевской премии Даниэля Канемана «Думай быстро, медленно».
Канеман разделяет мышление человека на две системы:
- Система 1 (System One): Быстрая, интуитивная, автоматическая, почти мгновенная реакция на знакомые паттерны (например, определить выражение лица собеседника, уловить опасность на дороге, отличить спам от важного письма за долю секунды).
- Система 2 (System Two): Медленная, осознанная, аналитическая работа, требующая концентрации усилий и последовательных шагов (решение уравнения, написание архитектурного документа, логическое доказательство теоремы).
Почему генеративные LLM ломают программные пайплайны
Большинство решений в бэкенд-сервисах — это не философские эссе, а конкретные дискретные выборы:
- «Относится ли эта транзакция к подозрительным?» (
trueилиfalse). - «В какой отдел направить этот тикет: биллинг, техподдержка или продажи?» (
billing | tech | sales). - «Насколько раздражён клиент по шкале от 1 до 5?» (
1..5).
Когда инженер заставляет тяжёлую генеративную модель, такую как GPT-6.1 Sol, Claude Opus 5.5 или Claude Fable, отвечать на такие вопросы, возникает фундаментальное несоответствие природе инструмента:
- Авто-регрессионная задержка: Модель обязана генерировать токены последовательно один за другим. Даже короткий ответ занимает 1.5–3 секунды из-за сетевых задержек и квантов генерации.
- Хрупкость JSON Mode: Генеративные модели нередко добавляют комментарии, пропускают кавычки или оборачивают ответ в
```json ... ```, вынуждая разработчиков писать сложные механизмы санитизации и повторных попыток (retry). - Экономическая неэффективность: Вы оплачиваете полную стоимость выходных токенов (output tokens), которые в коммерческих API стоят в 3–5 раз дороже входных.
- Деградация внимания (Context Rot): Если вы задаёте модели несколько последовательных вопросов в одном чате, растущий контекст размывает внимание и повышает вероятность ошибки.
Принцип Jev: Jev не имеет механизма авторегрессивной генерации текста для пользователя. Модель считывает входное состояние (state), пропускает его через трансформер и вычисляет нормализованные распределения вероятностей над заранее определёнными категориями за один прямой проход. Результат сразу возвращается в виде строго типизированной структуры данных.
2. Экономика, скорость и бенчмарки: $0.042 за 1M токенов и 100 мс
Экономика Jev меняет правила игры для высоконагруженных сервисов. Вместо оплаты за каждое выходное слово разработчики платят только за входные токены.
Сравнительная таблица стоимости и характеристик
| Характеристика | TypeSafe Jev 1.13 | OpenAI GPT-6.1 Sol | Anthropic Claude Opus 5.5 | Google Gemini 3.8 Flash |
|---|---|---|---|---|
| Класс архитектуры | System One (принятие решений) | System Two (генеративная) | System Two (генеративная) | System Two (генеративная) |
| Стоимость входных токенов (1M) | $0.042 | $3.00 | $5.00 | $0.10 |
| Стоимость выходных токенов (1M) | $0.00 (Бесплатно!) | $12.00 | $25.00 | $0.40 |
| Типовая задержка (P50) | ~90–120 мс | 1200–2400 мс | 1400–2800 мс | 400–700 мс |
| Лимиты пропускной способности | 100K tok/s, 40 RPS | Зависит от Tier | Зависит от Tier | Зависит от Tier |
| Контекстное окно запроса | 64 000 токенов | 256 000 токенов | 500 000 токенов | 2 000 000 токенов |
| Необходимость парсинга ответов | Отсутствует (нативные типы) | JSON.parse / Regex | JSON.parse / Regex | JSON.parse / Regex |
Выходные токены бесплатны: Поскольку Jev не генерирует свободный текст, TypeSafe тарифицирует только входной контекст (state + вопрос). Обработка 1 миллиарда токенов стоит всего $42. Для сравнения, такой же объём на GPT-6.1 Sol или Claude Opus 5.5 обойдётся как минимум в $3,000 – $7,500.
Реальный бенчмарк: MotherDuck (классификация текста в SQL)
Команда аналитической облачной базы данных MotherDuck интегрировала функцию prompt_jev() непосредственно в SQL-диалект для классификации текстовых записей в промышленных масштабах.
Результаты теста на датасете из 100 000 строк:
- Классическая frontier-LLM: время выполнения — 32 минуты, стоимость вычислений — $37.00.
- TypeSafe Jev: время выполнения — 40 секунд, стоимость вычислений — $0.50.
- Итог: Jev выполнил задачу в 48 раз быстрее и в 74 раза дешевле, продемонстрировав полный паритет по качеству классификации.
3. Анатомия запроса: Structured State и точечная адресация Dot-Path
Запрос к Jev состоит из двух фундаментальных компонентов:
state(состояние): Контекст задачи в виде простого текста, строки или вложенного JSON-документа (лог событий, транзакция, профиль пользователя, код, содержимое страницы).questions(набор вопросов): Словарь вопросов, которые модель должна одновременно оценить относительно переданного состояния.
Принцип изоляции контекста и предотвращение Context Rot
Классическая ошибка при работе с большими моделями — отправлять всю историю предыдущих диалогов и служебные промпты. В Jev действует правило строгой гигиены контекста: передавайте в state только те данные, которые необходимы для принятия конкретных решений. Модель получает состояние один раз и параллельно оценивает все вопросы.
Точечная адресация через Dot-and-Index Paths
Когда ваш state представляет собой сложный структурированный JSON-объект, вы можете ссылаться на конкретные поля и элементы массива непосредственно в тексте вопроса с помощью обратных кавычек (backticks):
Модель Jev специально оптимизирована для навигации по JSON-дереву. Когда она видит `transaction.amount_usd`, её слой внимания фокусируется именно на указанном ключе.
4. Три AI-примитива: детальный разбор Choice, Score и Noul
TypeSafe построила систему вокруг трёх минимальных, взаимодополняющих примитивов. Каждый из них предназначен для конкретного математического типа решения. В каждом подразделе ниже интегрирован отдельный интерактивный стенд, где вы можете выбрать готовый промпт и протестировать работу примитива в действии.
4.1. Примитив Choice: выбор из дискретного списка категорий
Choice применяется, когда ответом должна быть одна категория из фиксированного, неупорядоченного перечня вариантов.
Что возвращает Jev для Choice:
choice: Ключ выбранной категории (например,"technical").probabilities: Полное распределение вероятностей по всем опциям:{"billing": 0.04, "technical": 0.92, "sales": 0.02, "other": 0.02}.confidence: Число от0.0до1.0, которое измеряет чёткость доминирования лидера над другими вариантами.
Золотое правило Choice: Всегда добавляйте категорию other или none_of_the_above. Если входные данные не будут соответствовать ни одному из целевых вариантов, модель не будет вынуждена искусственно завышать вероятность неподходящей категории, а вместо этого выберет other или сообщит о низком уровне confidence.
4.2. Примитив Score: оценка по порядковой шкале или рубрике
Score предназначен для оценки свойств, находящихся на непрерывном или порядковом спектре: критичность бага, уровень стресса клиента, качество резюме кандидата, сложность кода.
Вы задаёте упорядоченный массив текстовых критериев (уровней):
Что возвращает Jev для Score:
score: Числовое значение в диапазоне от0доN-1. Важно: значение может быть дробным (например,2.37), если ситуация находится между вторым и третьим уровнями.probabilities: Полное распределение вероятностей по всем опциям шкалы:
4.3. Примитив Noul: калиброванная вероятность истинности утверждения
Термин Noul происходит от идеи бинарного суждения. Это вопрос, на который можно ответить «Да» или «Нет». Вместо простого булева значения Jev возвращает калиброванную вероятность того, что утверждение является истинным.
Что возвращает Jev для Noul:
noul: Число с плавающей запятой от0.0до1.0.- Значение
0.98означает уверенное «Да». - Значение
0.02означает уверенное «Нет». - Значение
0.50указывает на полную неопределённость модели.
- Значение
Noulне имеет отдельного поляconfidence, потому что само значениеnoulявляется математической оценкой вероятности.
4.4. Параллельная пакетная обработка (Parallel Batching)
Все три типа примитивов можно комбинировать в одном запросе в любом количестве.
В официальном cookbook TypeSafe эксперимент с пакетом из 13 вопросов к тексту GDPR показал, что объединение всех проверок в один запрос оказалось в 12,2 раза дешевле и в 10,0 раза быстрее, чем отправка 13 отдельных запросов, при полной идентичности полученных результатов.
5. Уверенность против Вероятности: Математика и Confidence-Gated Routing
Одна из ключевых проблем классических LLM — склонность к галлюцинациям и чрезмерной самоуверенности. Когда генеративная модель (даже уровня GPT-6.1 Sol или Claude Opus 5.5) сталкивается с граничным или недостаточно определённым контекстом, она пытается выдумать убедительный правдоподобный текст. Jev спроектирован с использованием алгоритмов обучения с подкреплением на основе калиброванных решений (RLCD), что позволяет модели честно сигнализировать: «Я не уверена».
Математическая разница
- Вероятность (
probability): отвечает на вопрос «Какова вероятность того, что правильным вариантом является X?». Это мера алеаторной неопределённости среди заданных опций. - Уверенность (
confidence): отвечает на вопрос «Насколько явно один вариант доминирует над всеми остальными?». Это мера эпистемической уверенности модели в своём выборе.
Для $K$ вариантов в запросе Choice формула нормализованного расчёта уверенности TypeSafe имеет вид:
$$\text{Confidence} = \max\left(0, \min\left(1, \frac{K \cdot p_{\max} - 1}{K - 1}\right)\right)$$
где:
- $K$ — общее количество доступных категорий.
- $p_{\max}$ — наивысшая вероятность среди всех категорий.
Пример интерпретации для 3 вариантов ($K = 3$):
-
Если вероятности распределены как
[0.90, 0.06, 0.04], то $p_{\max} = 0.90$.$\text{Confidence} = \frac{3 \cdot 0.90 - 1}{2} = \frac{1.7}{2} = 0.85$ (Высокая уверенность).
-
Если вероятности равномерны
[0.34, 0.33, 0.33], то $p_{\max} = 0.34$.$\text{Confidence} \approx \frac{3 \cdot 0.34 - 1}{2} = \frac{0.02}{2} = 0.01$ (У модели нет лидера, полная неопределённость).
Трёхуровневый шаблон маршрутизации (Confidence-Gated Routing)
Благодаря показателю confidence инженеры могут строить надёжные системы автоматизации с тремя контурами безопасности:
6. Архитектурные паттерны производственного уровня (Production Patterns)
Опыт сотен проектов на Jev позволил выкристаллизовать пять ключевых архитектурных шаблонов проектирования интеллектуальных систем.
6.1. Спекулятивный веер (Speculative Fan-Out)
В классическом коде разработчики сначала выполняют проверку условия, а затем вызывают следующую функцию. В мире Jev вопросы вычисляются параллельно, а добавление новых вопросов почти не изменяет время ответа.
Паттерн: отправляйте в первом же запросе не только обязательные, но и гипотетические вопросы, ответы на которые потребуются только в определённых ветках кода.
6.2. Композитный скоринг (Composite Scoring)
Вместо того чтобы просить модель абстрактно «оценить лид от 1 до 100», разбейте оценку на атомарные, объективные факторы. Сведите их в итоговый балл детерминированной математической формулой в вашем коде:
$$\text{LeadScore} = 0.40 \cdot \text{BudgetConfirmed} + 0.35 \cdot \text{DecisionMakerRole} + 0.25 \cdot \text{Urgency}$$
Если бизнес-приоритеты компании изменятся, вам не нужно переписывать промпт; достаточно изменить числовые коэффициенты в вашем коде.
6.3. Каскад структурированного извлечения (SDE Cascade)
Когда вам нужно извлечь сложные данные из неструктурированного текста, постройте двухступенчатый конвейер:
- Этап 1: Быстрый парсер или регулярные выражения находят потенциальные сущности (даты, суммы, ссылки, email).
- Этап 2 (Jev): Серия вопросов
ChoiceилиNoulверифицирует и выбирает среди кандидатов именно те, которые соответствуют контексту. - Этап 3 (Только для 2–3% коллизий): Если Jev возвращает
confidence < 0.5, запрос передаётся тяжёлой модели расширенного рассуждения (GPT-6.1 Sol или Claude Opus 5.5).
Такой подход сокращает общий чек за облачные LLM на 90–95%.
6.4. Файрвол вызова инструментов (Tool-Call Firewall)
AI-агенты, имеющие доступ к консоли или вызову инструментов (MCP, bash, SQL), несут огромный риск необратимого удаления данных или выполнения вредоносного кода.
С помощью Jev создаётся быстрый файрвол: каждая команда, сгенерированная агентом, перед выполнением отправляется в Jev с 5–7 вопросами безопасности:
- «Модифицирует ли эта команда системные файлы?»
- «Передаются ли конфиденциальные переменные окружения на внешние хосты?»
- «Соответствует ли действие исходному запросу пользователя?»
Задержка в 100 мс незаметна для агента, но надёжно защищает систему от опасных операций.
7. Практический кодинг: готовые пайплайны на TypeScript и Python
Ниже приведены готовые к продакшену примеры построения сервиса обработки входящих обращений клиентов и финансового риск-скоринга с помощью официальных SDK TypeSafe для TypeScript и Python.
7.1. Промышленные пайплайны: обработка обращений клиентов
typescriptimport { TypeSafeClient, choice, score, noul } from "@typesafe-ai/sdk"; // 1. Ініціалізація клієнта (бере TYPESAFE_API_KEY зі змінних середовища) const client = new TypeSafeClient(); interface SupportState { ticketId: string; userEmail: string; accountAgeDays: number; messageText: string; attachedLogs?: string; } export async function processCustomerMessage(ticket: SupportState) { try { // 2. Виклик System One з паралельними питаннями const response = await client.systemOne({ state: { ticket_id: ticket.ticketId, user_tier: ticket.accountAgeDays > 365 ? "vip" : "standard", content: ticket.messageText, logs: ticket.attachedLogs ?? "Немає логів" }, questions: { // Категоризація запиту (Choice) topic: choice("Яка основна тема звернення користувача?", { billing: "Проблеми з оплатою, картками, підпискою, запит на повернення грошей", bug_report: "Повідомлення про збій у додатку, помилку в інтерфейсі або API", feature_request: "Побажання щодо покращення функціоналу, нові інструменти", account: "Проблеми зі входом, зміна пошти або скидання пароля", other: "Питання, які не підпадають під жодну з попередніх категорій" }), // Оцінка за шкалою роздратування (Score) frustration_level: score("Наскільки користувач роздратований у `content`?", [ "Спокійний: діловий, нейтральний тон, виклад фактів", "Стурбований: відчувається легке невдоволення або нетерпіння", "Розлючений: агресія, погрози піти до конкурентів, скарги", "Екстремальний: ненормативна лексика, caps lock, вимога негайного дзвінка керівництва" ]), // Перевірка на терміновість (Noul) is_urgent: noul("Чи вказує користувач у `content`, що його продакшен зупинений або проблема критична для бізнесу?"), // Перевірка на наявність витоку секретів у тексті (Noul) contains_leaked_secrets: noul("Чи містить `content` або `logs` приватні API-ключі, токени доступу чи паролі?") } }); const { topic, frustration_level, is_urgent, contains_leaked_secrets } = response.answers; // 3. Детермінована логіка маршрутизації console.log(`[Ticket ${ticket.ticketId}] Тема: ${topic.choice} (Впевненість: ${topic.confidence.toFixed(2)})`); console.log(`[Ticket ${ticket.ticketId}] Рівень стресу: ${frustration_level.score.toFixed(2)}/3.00`); // Безпековий контур if (contains_leaked_secrets.noul > 0.85) { console.warn(`[SECURITY ALERT] Виявлено можливий витік ключів у тікеті ${ticket.ticketId}. Автоматичне маскування!`); } // Маршрутизація на основі впевненості if (topic.confidence < 0.50) { return { status: "manual_triage", reason: "Model uncertain about topic" }; } if (is_urgent.noul > 0.80 || frustration_level.score > 2.0) { return { status: "escalated_p1", department: topic.choice, priority: "CRITICAL", confidence: topic.confidence }; } return { status: "routed", department: topic.choice, priority: "NORMAL", confidence: topic.confidence }; } catch (error) { console.error("Помилка під час виклику Jev API:", error); throw error; } }
8. Разбор 10 лучших мировых кейсов с видеодемонстрациями (Receipts)
Сообщество инженеров на платформах shipwithjev.com, jevbest.com и jevable.com продемонстрировало десятки революционных применений Jev. Ниже приведён детальный разбор 10 ведущих мировых кейсов: слева расположен интерактивный плеер реальной демонстрации или телеметрии, а справа — структурированный анализ проблемы, архитектурного решения на Jev и подтверждённого чека скорости и стоимости.
8.1. Browser Use + Jev: Автономный агент поиска авиабилетов
8.2. Toolgate: Файрвол вызова инструментов MCP и Claude Code
8.3. Astra + Jev в Minecraft: Реалтайм-агент System One + Two
8.4. Jev Driver: Автономное управление автомобилем в браузере
8.5. 2048Jev: Jev играет в 2048 в режиме реального времени
8.6. Semantic Jev: Запросы на естественном языке через SQL
8.7. MotherDuck: Классификация prompt_jev() прямо в SQL
8.8. Jev Swap: Поиск вызовов LLM, которые нужно заменить на Jev
8.9. ElevenLabs: Детекция телефонных мошенников в реальном времени
8.10. Softlint: AI-линтер в CI для семантических правил кода
9. Интеграция в агентные пайплайны: Claude Code, Codex и MCP Toolgate
Современные автономные coding-агенты (Claude Code, OpenAI Codex, Antigravity, Cursor) сталкиваются с тремя критическими узкими местами: раздуванием контекста (Context Bloat) из-за десятков подключённых инструментов, нерациональным использованием сверхдорогих флагманских моделей для тривиальных задач и риском неконтролируемых деструктивных действий в терминале.
Jev System One выступает в роли сверхбыстрого рефлекторного слоя (L0/L1) агентной системы: он принимает дискретные решения за ~80–90 мс по цене менее $0.0003, оптимизируя весь рабочий цикл агента.
9.1. Динамическое ранжирование моделей для разных типов задач (Model Tier Routing)
В классических агентных пайплайнах разработчики либо жёстко закрепляют одну модель (например, Claude 3.7 Sonnet или GPT-4.5) для всех подзадач, либо вызывают тяжёлую LLM для анализа запроса, что добавляет 2–4 секунды задержки и лишние затраты на каждом шаге.
Jev классифицирует намерение и сложность задачи за ~85 мс, направляя запрос в соответствующий тир моделей:
- Fast Tier (быстрые микро-задачи): Форматирование кода, написание простых юнит-тестов, генерация валидаторов и документации. Направляется на Gemini 2.5 Flash или GPT-4o-mini ($0.05–$0.15 за 1M токенов).
- Balanced Tier (стандартное кодирование): Реализация фич, рефакторинг функций, интеграция API и исправление багов средней сложности. Направляется на Claude 3.5 Sonnet или DeepSeek V3 ($3.00 за 1M токенов).
- Deep Reasoning Tier (критическая архитектура): Глубокий анализ race conditions, проектирование баз данных, комплексный криптографический аудит. Направляется на Claude 3.7 Sonnet Thinking или OpenAI o3-mini ($12.00–$15.00 за 1M токенов).
Результат маршрутизации через Jev: Экономия затрат на API агента составляет от 65% до 82%, а первый ответ на мелкие задачи появляется в 4 раза быстрее, чем при использовании единой тяжёлой модели.
9.2. Ранжирование и загрузка скиллов по требованию (Dynamic Skill Selection)
Современный разработчик может иметь в окружении 30–80 агентских скиллов (skills/*), плагинов и инструментов. Если передавать полные спецификации и инструкции всех скиллов в системный промпт агента:
- Расходуются от 15,000 до 35,000 токенов на каждой итерации диалога.
- Модель начинает путаться в похожих инструментах (Tool Hallucination / Overload).
- Скорость первой реакции агента падает до 5–10 секунд.
Jev реализует архитектуру On-Demand Skill Ingestion. Агент держит в памяти только лёгкие однострочные описания доступных скиллов, а Jev на каждом шаге за ~80 мс ранжирует их и выбирает топ-1–2 наиболее необходимых:
Почему это работает быстрее: Вместо передачи 30k токенов агент отправляет в Jev только запрос пользователя (~200 токенов). Получив название нужного скилла, агент подгружает соответствующий файл SKILL.md непосредственно перед его выполнением. Это сохраняет окно контекста чистым для кода проекта.
9.3. Безопасный файрвол toolgate для MCP и терминала
Проект с открытым исходным кодом toolgate добавляет промежуточный слой проверки (middleware) для любых вызовов протокола Model Context Protocol (MCP). Каждый раз, когда автономный агент инициирует терминальную команду (bash, npm run, git reset) или перезапись файлов, Jev параллельно вычисляет 7 вероятностей деструктивного риска Noul:
- Опасное удаление файлов: Вероятность деструктивных действий (
rm -rf, удаление директорий вне репозитория). - Утечка чувствительных данных: Попытка вывести переменные окружения (
.env,AWS_SECRET_ACCESS_KEY, приватные SSH-ключи). - Эскалация привилегий: Использование
sudo, модификация системных файлов в/etc/или~/.ssh/. - Уничтожение истории Git: Вызовы
git push --forceили сброс веток без подтверждения. - Сетевые аномалии: Несанкционированное открытие сокетов или отправка данных на сторонние IP.
- Отклонение от исходной задачи (Scope Drift): Попытка агента изменить файлы, не относящиеся к поставленной задаче.
- Финансовая стоимость операции: Запуск тяжелых облачных скриптов или деплой без согласия пользователя.
Если совокупный индекс риска превышает порог 0.85, действие мгновенно блокируется, а оператор получает уведомление с точным описанием угрозы.
9.4. Сравнительная матрица: Классический агент против агента с Jev System One
| Параметр операции | Классический подход (Full Context / Heavy LLM) | Агент с интеграцией Jev System One | Выгода для проекта |
|---|---|---|---|
| Выбор модели под задачу | Фиксированная флагманская модель или тяжелый LLM-роутер (2–4 с, ~$0.02) | Jev System One Choice-роутер (~85 мс, $0.0003) | -98% задержки, -98.5% стоимости |
| Выбор и загрузка скиллов | Все 40–80 скиллов в промпте (25,000+ токенов на шаг) | Ранжирование за 80 мс и загрузка 1–2 скиллов on-demand | Экономия до 90% контекста |
| Контроль безопасности инструментов | Простые regex-правила или полное отсутствие защиты | 7 параллельных проверок Noul перед каждым вызовом инструмента | Защита от несанкционированных действий |
| Скорость старта агента | 4–9 секунд ожидания первого токена | 600–900 мс до начала выполнения шага | Старт в 5–7 раз быстрее |
| Средняя стоимость 100 шагов агента | ~$4.50 – $8.00 | ~$0.85 – $1.40 | Экономия средств на 75–85% |
9.5. Установка официального скилла для агентов
TypeSafe предоставляет готовые интеграционные плагины и скиллы для популярных сред разработки:
bashclaude plugin marketplace add typesafe-ai/skills claude plugin install typesafe@typesafe-ai
Скилл обучает агента трем критическим правилам:
- Всегда группировать связанные проверки в один параллельный вызов
client.systemOne. - Использовать паттерн Speculative Fan-Out вместо последовательных опросов.
- Хранить запросы и пороговые константы в отдельном конфигурационном файле для прозрачного аудита человеком.
9.6. Готовый инструментарий Claude Code от Юрия (@yuriisams)
Разработчик и практик Юрий (@yuriisams) создал готовую автоматизацию на базе Jev непосредственно для терминального агента Claude Code. Это два автономных инструмента, которые встраиваются как хуки UserPromptSubmit и автоматически срабатывают на каждое сообщение пользователя, оставляя разработчику полный контроль.
По умолчанию оба инструмента отключены: пока они не активированы, Claude Code работает в стандартном режиме и никуда не отправляет данные. Если сервис Jev недоступен или уверенность модели низкая, Claude так же незаметно продолжает штатное выполнение.
| Инструмент в архиве | Назначение | Как работает под капотом | Где размещается |
|---|---|---|---|
jev-router.zip | Маршрутизатор моделей | Jev классифицирует задачу (tiny, everyday, large, hardest), после чего Claude отвечает сам или вызывает Haiku, Sonnet или Opus. | ~/.jev-router/router.py |
jev-skills.zip | Подборщик скилов | Jev просматривает скилы в ~/.claude/skills/; при уверенности $\ge 60%$ предлагает Claude нужный скил вместо угадывания. | ~/.jev-skills/hook.py |
Jev-README.md | Руководство | Полная пошаговая инструкция на украинском языке и настройка конфигурации. | Корень архива |
Пошаговая установка на рабочую машину
bash# Створюємо тимчасову теку та завантажуємо авторський архів mkdir -p ~/jev-setup && cd ~/jev-setup curl -L -o JEV-Guide.zip https://gotburnout.io/downloads/JEV-Guide.zip unzip JEV-Guide.zip
Подключение хуков в ~/.claude/settings.json
В файле конфигурации ~/.claude/settings.json добавьте хуки в массив hooks.UserPromptSubmit (не удаляя другие существующие хуки):
Инструкция для модели: Добавьте содержимое файла claude-md-snippet.md из архива в ваш глобальный файл ~/.claude/CLAUDE.md. Это научит самого Claude корректно реагировать на служебные теги маршрутизатора и подборщика скилов.
Управление и быстрые команды в терминале
После перезапуска Claude Code вы можете в любой момент включать или отключать инструменты:
-
Управление маршрутизатором моделей:
jev router on/jev router off/jev router status. -
Управление подбором скилов:
jev skills on/jev skills off/jev skills status. -
Разовая проверка без активации хуков:
bashpython3 ~/.jev-skills/picker.py "налаштувати nginx для reverse proxy з ssl"
Скачать готовый архив JEV-Guide.zip от Юрия (@yuriisams) →
10. Подводные камни, ограничения Jev 1.13 и чек-лист внедрения
Jev — мощный инструмент, но он не является универсальной серебряной пулей. Понимание его границ позволяет избежать критических ошибок на этапе проектирования.
Известные шероховатости (Jagged Edges) текущей версии jev-1.13.0
- Контекстные лимиты: Максимальный размер запроса составляет 64k токенов, но состояние (
state) плюс самый длинный вопрос не должны превышать 32k токенов. При приближении к границе 32k точность модели начинает плавно снижаться. - Только текст: Jev не поддерживает прямой приём изображений, видео или аудио. Все медиаданные перед передачей в
stateдолжны быть транскрибированы (например, через Whisper) или преобразованы в структурированный текст. - Языковая специфика: Модель обучалась преимущественно на англоязычном корпусе данных. Она способна обрабатывать украинский, польский или испанский языки, однако наивысшая точность достигается по следующей схеме:
Совет
Совет для локализованных проектов: Передавайте локальный текст пользователя (например, на украинском) в поле
state, но сами инструкции (instructions) и критерии (criteria) вопросов пишите на английском языке. Jev отлично соотносит англоязычные правила с украиноязычным контекстом.
Чек-лист подготовки к запуску в продакшен
- В теле статьи и сервиса отсутствуют лишние системные промпты; передаётся только чистый
state. - Все вопросы Choice содержат категорию по умолчанию (
otherилиnone_of_the_above). - Связанные вопросы сгруппированы в один параллельный вызов
client.systemOne. - Реализована трёхуровневая маршрутизация на основе
confidence(Tier 1 / Tier 2 / Tier 3). - Пороги уверенности дифференцированы: выше для деструктивных операций ($>0.90$) и умеренные для read-only операций ($>0.60$).
- Настроена автоматическая повторная попытка (retry) с экспоненциальным backoff для обработки возможных HTTP 429 Rate Limit.
- Константы вопросов и пороговые значения вынесены в отдельный конфигурационный файл.
- Проверен размер входного состояния (не превышает 32k токенов на один вопрос).
- Предусмотрен fallback-маршрут на классическую reasoning LLM для аномально низкой уверенности.
- Логируются значения
response.modelиanswers.*.confidenceдля последующего анализа распределения решений.
11. Локальные Open-Weight альтернативы: Laya, GLiNER2.5-Decide и CLM-8B
Хотя облачный Jev от TypeSafe предлагает чрезвычайно доступные тарифы ($0.042 за 1M токенов), для многих корпоративных систем критически важно иметь полный контроль над данными (On-Premise, GDPR, HIPAA, банковская тайна) или нулевую зависимость от сторонних API и сетевых задержек.
Сообщество с открытым исходным кодом быстро переняло парадигму System One и выпустило открытые модели решений (Open-Weight Decision Models), которые можно запустить локально на собственном сервере, GPU или даже ноутбуке с Apple Silicon.
11.1. Laya от Convai Innovations: прямой open-source двойник Jev
Laya — это первый открытый прямой аналог Jev, построенный по той же философии: неавторегрессивная модель решений, которая никогда не генерирует свободный текст, а оценивает типизированные вопросы за один прямой проход трансформера (~33 мс на GPU).
Модель обучена с помощью обучения с подкреплением на основе строго корректных правил оценки (RLCD — Reinforcement Learning for Calibrated Decisions), что гарантирует математически честную калибровку вероятностей.
- Стек и архитектура: энкодер ModernBERT-large (421M параметров) для английского языка и mmBERT-base (322M параметров) для 100+ языков мира.
- Поддержка примитивов: нативная поддержка
choice,scoreиnoulс тем же форматом запросов и ответов, что и у TypeSafe Jev. - Контекст документов: поддерживает до 1024 токенов по умолчанию и до 8192 токенов в версии
laya-multilingual(max_len=8192). - Совместимый сервер
laya-serve: содержит встроенный прокси, который реализует эндпоинтPOST /v1/systemone. Вы можете заменить облачный Jev в существующих приложениях, просто изменивbaseURLнаhttp://localhost:8000. - Скорость и стоимость: около 33 мс на GPU (в 6–8 раз быстрее сетевого вызова к облачному Jev) и $0 стоимости по лицензии Apache 2.0.
pythonfrom laya import Router # Preload моделей у пам'ять для миттєвої маршрутизації (<35 мс) router = Router(preload=True) state = "Користувач скаржиться на подвійне списання коштів за підписку і вимагає повернення." questions = { "department": { "type": "choice", "instructions": "Which department should handle this request?", "criteria": { "billing": "invoices, payments, refunds", "tech_support": "bugs, outages, system errors", "other": "everything else" } }, "churn_risk": { "type": "noul", "instructions": "Does the user threaten to cancel or express high churn risk?" } } result = router.predict(state, questions) print("Відділ:", result["answers"]["department"]["choice"]) print("Ризик відтоку:", result["answers"]["churn_risk"]["noul"])
Многоязычность: Router автоматически определяет язык текста (в том числе украинский) и направляет неанглийские запросы в чекпоинт laya-multilingual, обеспечивая качественную классификацию на 45+ языках без ручного переключения весов.
Открыть репозиторий на Hugging Face: convaiinnovations/laya →
11.2. GLiNER2.5-Decide от Fastino: 340M схемо-ориентированный классификатор
GLiNER2.5-Decide — это специализированная модель от лаборатории Fastino, предназначенная для операционной классификации, фильтров безопасности и маршрутизации задач без необходимости писать промпты или парсить выходные токены.
Модель основана на архитектуре DeBERTa-v3-large (340M параметров) и превосходит коммерческий JevK5 на бенчмарке fast-decisions (60.2% точности против 57.6% у Jev).
- Динамический набор меток: список категорий передается непосредственно в вызове функции во время выполнения без переобучения (Zero-Shot).
- Поддержка Multi-Label: может одновременно возвращать несколько меток (например, определить несколько аспектов отзыва или проблем клиента) по порогу
cls_threshold. - Метки с описаниями (Label Descriptions): если название метки неоднозначно, для неё можно передать развернутое описание — модель учитывает его при принятии решения.
- Порядковые шкалы и QA: поддерживает числовые уровни срочности (например, от
"0"до"5"), оценку тональности и бинарные вопросы (yes/no) к переданному фрагменту текста. - Минимальные требования к оборудованию: 340M параметров позволяют модели работать с задержкой в единицы миллисекунд даже на обычном процессоре (CPU).
Открыть репозиторий на Hugging Face: fastino/GLiNER2.5-Decide →
11.3. CLM-v0.1-8B от Contrastive-LM: контрастивный скоринг действий на базе Qwen3
CLM-v0.1-8B (Contrastive Language Model) — это разработка исследователей из Stanford и NVIDIA (сентябрь 2026), созданная для молниеносного выбора действий внутри агентных пайплайнов (Computer Use, Tool Calling и верификация шагов).
Вместо медленной пошаговой генерации текста модель работает по контрастивному принципу: она проецирует текущее состояние (state) и список возможных действий или вызовов инструментов в общее векторное пространство, после чего ранжирует их по косинусной близости.
- Стек и архитектура: замороженный энкодер Qwen3-8B в сочетании с легкими обученными контрастивными проекционными головками (~20M параметров).
- Ускорение агентов: обеспечивает до 9 раз меньшую задержку (latency) по сравнению с генеративными LLM при выборе нужного инструмента среди большого списка функций.
- Action Caching (кеширование действий): поскольку состояние и действия кодируются раздельно, векторные эмбеддинги статичных инструментов или системных функций можно рассчитать один раз и сохранить в оперативной памяти.
- Поддержка локального железа: открытые веса под лицензией Apache 2.0 и официальные оптимизации для Apple MLX позволяют развертывать модель на рабочих станциях и Mac с единой памятью (unified memory).
Открыть репозиторий на Hugging Face: Contrastive-LM/CLM-v0.1-8B →
11.4. Сводная таблица: Jev против открытых альтернатив System 1
| Модель | Разработчик / организация | Архитектура и размер | Задержка (P50) | Основной фокус и ключевые возможности | Drop-in-совместимость с Jev | Лицензия |
|---|---|---|---|---|---|---|
| TypeSafe Jev 1.13 | TypeSafe AI | Собственная проприетарная архитектура | ~90–120 мс | Облачная модель System One, 3 примитива, калиброванная уверенность (confidence) | Официальный API | Коммерческая ($0.042/1M) |
| Laya | Convai Innovations | ModernBERT-large (421M) / mmBERT (322M) | ~33 мс (GPU) | 1:1-поддержка Choice/Score/Noul, 100+ языков, калибровка RLCD | Да (laya-serve) | Apache 2.0 (открытое ПО) |
| GLiNER2.5-Decide | Fastino AI | DeBERTa-v3-large (340M) | ~15–40 мс | Многоклассовая классификация, описания меток, отличная работа на CPU | Нет (собственный SDK gliner2) | Apache 2.0 (открытое ПО) |
| CLM-v0.1-8B | Contrastive-LM (Stanford / NVIDIA) | Замороженный Qwen3-8B + проекционные головки (~8B) | ~50–80 мс | Контрастивный скоринг действий агентов, Action Caching, Apple MLX | Нет (контрастивный роутер) | Apache 2.0 (открытое ПО) |
11.5. Как выбрать локальную модель для своего стека
Практическое правило выбора локального движка System 1:
- Выбирайте Laya (
convaiinnovations/laya), если вы уже спроектировали пайплайн под примитивы TypeSafe Jev (choice,score,noul), нуждаетесь в мультиязычной обработке (в том числе украиноязычных текстов) или хотите перевести существующий продакшен на собственный сервер без переписывания кода с помощьюlaya-serve. - Выбирайте GLiNER2.5-Decide (
fastino/GLiNER2.5-Decide), если ваша задача состоит в быстрой классификации сообщений, поддержке multi-label категорий (несколько тегов одновременно), работе со сложными описательными метками или если требуется развернуть сервис на серверах с ограниченными ресурсами без дискретных GPU. - Выбирайте CLM-v0.1-8B (
Contrastive-LM/CLM-v0.1-8B), если вы строите автономного AI-агента с богатым набором инструментов (MCP / Tool Calling) и ищете максимальную скорость верификации действий и защиты от ошибок за счёт кэширования эмбеддингов инструментов.